Blog

  • La biofarmacéutica española Diater, víctima de un supuesto ataque de ransomware

    La biofarmacéutica española Diater, víctima de un supuesto ataque de ransomware

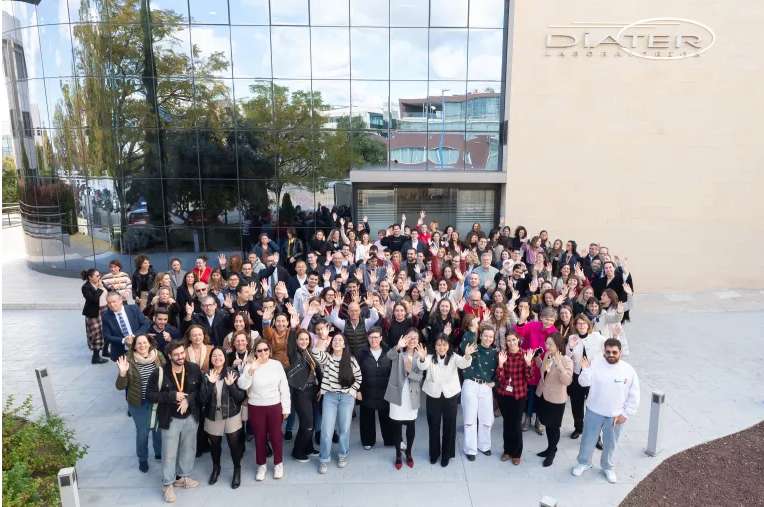
    El grupo de ransomware DeadLock ha incorporado a una nueva empresa española a su página de víctimas de la dark web. En esta ocasión se trata de la compañía biofarmacéutica Diater.

    El actor de amenazas asegura haber obtenido un listado de directorios que contiene carpetas de usuarios, documentos, archivos QM y archivos relacionados con EDICOM.

    Por el momento, se desconoce qué cifra habría pedido el colectivo a la firma en concepto de rescate. Tampoco se ha hecho pública la fecha exacta del incidente ni se ha dado a conocer un inventario detallado de los datos comprometidos. 

    Las empresas médicas suelen almacenar nombres, fechas de nacimiento, números de identificación nacional, datos de contacto, historiales clínicos, resultados de pruebas de alergia e información de pago. De confirmarse el incidente, se abriría la puerta a posibles robos de identidad, fraudes a seguros y estafas dirigidas usando los historiales médicos reales. 

    Además, las filtraciones de datos como estas suelen propagarse por foros clandestinos en días o semanas, maximizando los riesgos para los afectados. 

    Fundada en Madrid en 1999, Diater es una firma biotecnológica puntera dedicada a la investigación, desarrollo y fabricación de soluciones para el diagnóstico y tratamiento de alergias mediante inmunoterapia con alérgenos (ASIT).

    La compañía destaca por haber sido pionera en el diseño de inmunoterapias moleculares para alérgenos críticos, lo que le permite ofrecer tratamientos de alta precisión y personalizados para pacientes que sufren cuadros alérgicos complejos.

    A nivel estructural, el Grupo Diater está integrado por Allergen Servilab en España y por Diater Laboratorios, que opera a través de tres entidades repartidas entre el mercado español, portugués y alemán.

    Desde 2023, la corporación forma parte de la biofarmacéutica china WORG Pharmaceuticals, una compañía en fase clínica con dirección internacional que impulsa la expansión y el desarrollo de terapias innovadoras contra enfermedades alérgicas y autoinmunes.

    La política de privacidad de Laboratorios Diater confirma que la compañía trata datos personales especialmente sensibles, entre ellos información de pacientes relacionada con reacciones adversas, medicamentos, dosis, frecuencia de administración y datos de historia clínica. También recoge datos de profesionales sanitarios como DNI, datos de contacto, colegiación, información laboral y, en determinados casos, datos bancarios y firmas.

    En caso de que el ciberataque de DeadLock haya supuesto exfiltración de información, el impacto podría ser especialmente grave por la naturaleza de los datos sanitarios. La política señala además que la información de farmacovigilancia puede conservarse durante al menos diez años después de la finalización de la comercialización del medicamento, por lo que potencialmente podrían existir registros antiguos.

    Desde Escudo Digital nos hemos puesto en contacto con la compañía para conocer más detalles sobre el supuesto incidente y actualizaremos la información si recibimos respuesta. 

    Un grupo de extorsión con un añito de vida

    El ransomware DeadLock, detectado por primera vez a mediados de 2025, es una sofisticada amenaza asociada a actores de origen ruso, aunque su infraestructura técnica emplea tácticas similares a las de grupos de Corea del Norte.

    Este grupo de extorsión destaca por su capacidad de evasión al ocultar su infraestructura de comando y control utilizando contratos inteligentes en la blockchain de Polygon, una técnica conocida como EtherHiding. 

    Además, ha evolucionado rápidamente hacia un modelo de doble extorsión, donde no solo cifran los archivos bajo la extensión .dlock, sino que exfiltran la información para venderla en la dark web.

    Para presionar a las organizaciones que han sido comprometidas, el grupo despliega un archivo HTML local que obliga a canalizar las negociaciones del rescate mediante la aplicación de mensajería cifrada Session, exigiendo pagos anónimos en criptomonedas.

    A nivel global, la banda acumula cerca de 90 víctimas confirmadas en múltiples países, operando con una motivación puramente financiera que no discrimina regiones. Hasta la fecha sus ataques se han dirigido a múltiples sectores, como la manufactura, la logística, los servicios profesionales, la salud e instituciones públicas de tamaño medio. 

    España se sitúa como uno de los objetivos principales de este ransomware en Europa. Entre sus víctimas hay empresas como Grupo Relesa, Consulting Valladolid y Gerusia S.L., abarcando también a organizaciones de la automoción, el sector inmobiliario, servicios legales y la hostelería.

  • ShinyHunters se atribuye un ciberataque contra EY y amenaza con publicar información de clientes

    ShinyHunters se atribuye un ciberataque contra EY y amenaza con publicar información de clientes

    El grupo de extorsión ShinyHunters ha reivindicado el ciberataque sufrido por Ernst & Young (EY) y asegura haber sustraído documentación con información fiscal y financiera de clientes de la consultora. 

    En el mensaje publicado en su portal de filtraciones, ShinyHunters afirma que obtuvo acceso a la infraestructura de la firma a través de un proveedor externo comprometido

    Según el grupo, esa intrusión le permitió acceder a herramientas internas como Jira, GitHub y Azure y descargar documentación relacionada con clientes y operaciones internas de la firma. 

    Entre los detalles que dice haber obtenido el actor de amenazas figuran documentos fiscales, datos financieros y otra documentación corporativa, aunque no ha aportado pruebas que permitan verificar de forma independiente el alcance del robo.

    La consultora reconoció semanas atrás haber sufrido un incidente de seguridad que afectó a una plataforma de soporte de TI gestionada por un tercero y utilizada por equipos del área fiscal. 

    De acuerdo con la investigación interna llevada a cabo, un actor no autorizado accedió al sistema entre el 28 de marzo y el 12 de abril y descargó documentos adjuntos a incidencias de soporte.

    EY explicó que esos archivos podían contener información sensible de clientes, incluyendo nombres, direcciones, números de la Seguridad Social en EE.UU., datos bancarios y otra documentación utilizada para la preparación de declaraciones fiscales. La compañía indicó además que estaba notificando a los afectados y ofreciéndoles dos años de servicios de monitorización de identidad y crédito.

    Tras la reivindicación de ShinyHunters, diversos medios han solicitado una actualización a EY para conocer si la compañía confirmaba la identidad de los responsables o había recibido una demanda de rescate. Hasta el momento, la consultora no ha realizado nuevas declaraciones.

    Una caza tras otra

    ShinyHunters es uno de los grupos de ciberdelincuentes especializados en robo y extorsión de datos más conocidos de los últimos años. Su nombre hace referencia, según los investigadores, a los jugadores de Pokémon que buscan los raros ejemplares ‘shiny’.

    Surgido en torno a 2020, comenzó ganando notoriedad por la venta de bases de datos robadas en foros clandestinos antes de evolucionar hacia un modelo de doble extorsión, en el que combina la sustracción de información con la amenaza de hacerla pública si la víctima no paga un rescate. 

    Entre sus víctimas figuran empresas tecnológicas como GitHub, AT&T o Snowflake (en un incidente que afectó a Santander y a Ticketmaster), la web pornográfica Pornhub o la firma de joyas Pandora. Una de las últimas habría sido la plataforma educativa, Canvas, que con casi 9.000 centros afectados decidió llegar a un acuerdo para pagar un rescate a estos cibermalos. 

    La actividad de ShinyHunters ha provocado distintas actuaciones policiales. En junio de 2024, las autoridades francesas detuvieron a un presunto integrante del grupo en relación con varios ciberataques de alto perfil, mientras que en 2025 EE.UU. acusó formalmente a varios presuntos miembros por su participación en campañas de intrusión, fraude y extorsión contra empresas de todo el mundo. 

  • Los datos de más de 700.000 fieles expuestos por una vulnerabilidad en la app de oración del Vaticano

    Los datos de más de 700.000 fieles expuestos por una vulnerabilidad en la app de oración del Vaticano

    Click To Pray, la aplicación oficial de oración de la Red Mundial de Oración del Papa, ha dejado expuestos los datos personales de más de 700.000 usuarios. El fallo permitía consultar información de otras cuentas sin autorización y estuvo activo durante meses, según una investigación publicada por Cybernews.

    El problema fue identificado por un investigador de seguridad identificado como BobDaHacker, quien informó de manera responsable de la vulnerabilidad el pasado 3 de enero. Sin embargo, durante meses no recibió respuesta por parte de los responsables de la plataforma y el fallo continuó funcionando hasta que el caso se hizo público.

    El problema se encontraba en una de las API de la app, es decir, en el mecanismo que permite que una aplicación se comunique con sus servidores para pedir o enviar información. 

    En este caso, el fallo estaba en cómo la plataforma comprobaba quién podía acceder a cada perfil. Cada usuario tenía asignado un número identificador y la API permitía cambiar ese número para consultar los datos de otra cuenta sin comprobar correctamente si se tenía permiso para hacerlo. Este tipo de error se conoce como IDOR (Insecure Direct Object Reference)

    Por otro lado, parece que el sistema no contaba con suficientes mecanismos para limitar el número de consultas que podía realizar una misma persona. Esto facilitaba la automatización. En lugar de consultar los perfiles uno a uno, un atacante podría crear un programa que fuera cambiando automáticamente los números y realizando peticiones consecutivas al servidor. La investigación identificó 719.517 cuentas registradas en el sistema en el momento de las pruebas.

    Entre los datos que podían quedar expuestos se encontraban nombres y apellidos, direcciones de correo electrónico, país de procedencia, fechas de nacimiento, rol de la cuenta y determinada información relacionada con el estado de los perfiles.

    Con estos detalles en su poder, los cibermalos pueden crear campañas de phishing más creíbles. Un atacante podría hacerse pasar por la propia plataforma o por una organización relacionada con el Vaticano y utilizar esos datos para intentar engañar al usuario.

    La investigación también encontró problemas en el sistema utilizado para verificar las direcciones de email. También se señalaron deficiencias en la configuración de mecanismos de seguridad del correo electrónico como SPF, DKIM y DMARC, que ayudan a evitar que terceros suplanten una dirección legítima para enviar mensajes fraudulentos.

    Por qué puede ser peligroso

    El incidente demuestra que una aplicación puede tener un problema grave de seguridad incluso cuando los usuarios tienen que identificarse correctamente para utilizarla. Autenticación y autorización no son lo mismo: la primera comprueba quién eres; la segunda determina qué puedes hacer o qué información puedes consultar. En este caso, el problema estaba precisamente en la segunda parte.

    Las API son especialmente importantes en este contexto porque actúan como una puerta de entrada a los datos que manejan muchas aplicaciones móviles y servicios web. Si los servidores no comprueban correctamente los permisos en cada petición, un fallo aparentemente sencillo puede terminar permitiendo el acceso a información de un número muy elevado de usuarios.

    El caso de Click To Pray se produce además mientras el Vaticano refuerza sus capacidades frente a las amenazas digitales. Hace justo hace dos años, en julio de 2024, el Estado de la Ciudad del Vaticano y la Agencia Nacional de Ciberseguridad de Italia firmaron un acuerdo de colaboración para mejorar la prevención y la respuesta frente al ciberdelito, compartir información y desarrollar iniciativas de formación en ciberseguridad.

  • Apple corrige casi 600 vulnerabilidades de seguridad en sus sistemas operativos

    Apple corrige casi 600 vulnerabilidades de seguridad en sus sistemas operativos

    Apple ha anunciado que ha publicado parches para corregir múltiples vulnerabilidades identificadas respecto a sus sistemas operativos. La compañía de Cupertino habría solventado 87 exploits con el lanzamiento de las versiones de iOS 26.6 e iPadOS 26.6

    Estas vulnerabilidades pueden ser explotadas para acceder a datos confidenciales de los usuarios, obtener sus huellas digitales, provocar una denegación de servicio (DoS), ejecutar código arbitrario, eliminar archivos, modificar el sistema de archivos, eludir la seguridad, agregar contactos sin autorización, falsificar la interfaz de usuario y escalar privilegios.

    La cosa iría más allá en cuanto a su sistema operativo de escritorio. En macOS Tahoe 26.6 la empresa de la manzana ha solucionado 155 vulnerabilidades. Entre ellas había algunas que posibilitaban el acceso a datos confidenciales del usuario, la ejecución de código arbitrario, la elusión de medidas de seguridad y los ataques de denegación de servicio (DoS).

    Las versiones antiguas del SO no han quedado exentas de arreglos. MacOS Sequoia 15.7.8 incluye correcciones para 138 exploits, mientras que macOS Sonoma 14.8.8 resuelve 127 problemas de seguridad. 

    De la muñeca a los ojos

    Respecto al resto de sistemas operativos de la manzana mordida (watchOS, tvOS y visionOS), Apple ha dado carpetazo a un centenar de fallos en cada uno de ellos. 

    Para concluir, la compañía de Tim Cook ha publicado parches para cerca de una docena de vulnerabilidades en su navegador Safari. Algunas de ellas abrían la puerta al acceso de datos confidenciales del usuario o a provocar el bloqueo del browser. 

    Estos fallos, aparentemente, no podían explotarse en entornos reales. 

  • Un hacker asegura haber robado datos de más de 3 millones de pensionistas españoles

    Un hacker asegura haber robado datos de más de 3 millones de pensionistas españoles

    Un actor de amenazas ha publicado en un foro de la ciberdelincuencia un anuncio en el que afirma haber obtenido una base de datos con 3.184.288 registros de pensionistas del Instituto Nacional de la Seguridad Social (INSS). 

    El actor malicioso sostiene que intentó negociar previamente con el organismo ofreciéndoles evitar la divulgación de la información, pero, al no obtener respuesta, decidió poner a la venta la supuesta base de datos. 

    El pirata informático afirma que el repositorio original incluiría también otros archivos, como documentos PDF e imágenes, aunque indica que solo ha publicado una muestra reducida como prueba de la supuesta intrusión.

    El ciberdelincuente ha puesto a la venta los supuestos datos por un precio de 5.000 euros. Según explica, la información fue obtenida mediante TerciosRAT, un troyano de acceso remoto que permite a los atacantes controlar un equipo comprometido de forma remota. 

    A falta de confirmación 

    Por el momento, no hay confirmación oficial de que el INSS haya sufrido una brecha de seguridad ni de que la base de datos ofrecida sea auténtica. Desde Escudo Digital nos hemos puesto en contacto con el departamento de prensa del Ministerio de Inclusión, Seguridad Social y Migraciones, del cual depende el INSS, para conocer más detalles y contrastar la información. 

    Como ocurre con frecuencia en este tipo de foros, los anuncios pueden contener información exagerada, reutilizada o incluso falsa, por lo que conviene tratar estas afirmaciones con cautela hasta que las autoridades o el propio organismo se pronuncien.

    El anuncio ha sido publicado por un usuario identificado como ‘mor3nako’. Por el momento, no existen atribuciones públicas que permitan vincular este alias con campañas de ciberataques previas o con un grupo de amenazas conocido, por lo que su historial y credibilidad son desconocidos.

  • El dilema de la hiperconectividad: la carrera por blindar las futuras redes 6G antes de su despliegue

    El dilema de la hiperconectividad: la carrera por blindar las futuras redes 6G antes de su despliegue

    Mientras los desplegables comerciales de quinta generación (5G) continúan consolidándose en la infraestructura global, los consorcios internacionales de telecomunicaciones, agencias de defensa y fabricantes de chips libran una batalla silenciosa en el diseño conceptual del estándar 6G. Esta próxima generación no se limita a ofrecer descargas más rápidas; proyecta integrar frecuencias de THz (terahercios), comunicación holográfica, gemelos digitales en tiempo real y la convergencia absoluta entre las redes terrestres y los satélites en órbita baja.

    Sin embargo, cada salto cualitativo en velocidad y capacidad multiplica exponencialmente la superficie de ataque. La arquitectura del 6G trasciende la conectividad tradicional para convertirse en una red de redes nativa de inteligencia artificial donde la toma de decisiones sobre el tráfico, el enrutamiento y la asignación de recursos ocurrirá de forma autónoma en milisegundos.

    Asegurar esta malla tecnológica exige replantear el paradigma defensivo desde los fundamentos del hardware hasta los protocolos de orquestación en la nube. La ciberseguridad ya no puede contemplarse como una capa superpuesta post-despliegue, sino como un requisito de diseño integrado en cada componente de la futura red.

    La metamorfosis técnica: qué cambia realmente con la llegada del 6G

    El estándar 6G está diseñado para operar en el espectro sub-terahertziano y de terahercios ($100\text{ GHz}$ a $3\text{ THz}$), lo que permite velocidades de transmisión de datos estimadas en hasta un terabit por segundo ($1\text{ Tbps}$) con latencias inferiores a los $0.1\text{ milisegundos}$. A diferencia de generaciones anteriores, donde las antenas transmitían datos a dispositivos pasivos, el 6G funcionará bajo el concepto de Joint Communication and Sensing (JCAS), convirtiendo a la propia red inalámbrica en un radar masivo capaz de mapear e interpretar el entorno físico.

    +---------------------------------------------------------------------------------+
    |                       ARQUITECTURA DE SEGURIDAD EN 6G                           |
    |                                                                                 |
    |   +-------------------------------------------------------------------------+   |
    |   |            CONVERGENCIA SATELITAL Y TERRESTRE (Non-Terrestrial)        |   |
    |   +------------------------------------+------------------------------------+   |
    |                                        |                                        |
    |                                        v                                        |
    |   +------------------------------------+------------------------------------+   |
    |   |          ORQUESTACIÓN AUTÓNOMA Y NATIVA DE IA (Zero-Trust)              |   |
    |   +------------------------------------+------------------------------------+   |
    |                                        |                                        |
    |                                        v                                        |
    |   +-----------------------+   +-----------------------+   +-----------------+   |
    |   |   Segmentación Edge   |   |   Criptografía PQC    |   | Malla JCAS      |   |
    |   |   (Zero latency)      |   |   (Anti-Cómputo Q)    |   | (Radar Físico)  |   |
    |   +-----------------------+   +-----------------------+   +-----------------+   |
    |                                                                                 |
    +---------------------------------------------------------------------------------+
    

    Esta capacidad de sensorización masiva implica que la red no solo transportará paquetes de datos, sino que rastreará movimientos, objetos y constantes biométricas en tiempo real. La arquitectura pasa de ser una infraestructura puramente digital a un ecosistema físico-digital interconectado.

    La virtualización extrema también alcanza niveles inéditos. Mediante la fragmentación profunda de red (Deep Network Slicing), un solo soporte físico compartirá miles de subredes virtuales aisladas dedicadas a servicios críticos tan variados como cirugía remota, vehículos autónomos interconectados o gestión de redes eléctricas de alto voltaje.

    El reverso de la medalla: los nuevos vectores de amenaza en la era 6G

    El incremento desproporcionado en la densidad de dispositivos conectados y la dependencia absoluta de software en la nube generan vulnerabilidades críticas que no existían en las redes celulares del pasado.

    +-----------------------------------------------------------------------------------+
    |                        AMENAZAS ESPECÍFICAS EN REDES 6G                           |
    |                                                                                   |
    |   +-----------------------+     +-----------------------+     +---------------+   |
    |   |    Ataques Adversarios|     | Infección en la Malla |     |  Intercepción |   |
    |   |      a la IA          |     |    Satelital (NTN)    |     |  Física JCAS  |   |
    |   |                       |     |                       |     |               |   |
    |   | Envenenamiento de     |     | Compromiso de enlaces |     | Espionaje vía |   |
    |   | modelos de enrutamiento|    | láser inter-satelital |     | señales THz   |   |
    |   +-----------+-----------+     +-----------+-----------+     +-------+-------+   |
    |               |                             |                         |           |
    |               +----------------------+------+-------------------------+           |
    |                                      v                                            |
    |                        [ COMPROMISO SISTÉMICO DE RED ]                            |
    |             (Caída de Servicios Críticos, Interrupción de Smart Cities)          |
    +-----------------------------------------------------------------------------------+
    

    Uno de los puntos más vulnerables es la exposición a ataques adversarios contra la inteligencia artificial. Dado que la gestión del tráfico y la asignación de frecuencias en 6G estarán administradas por modelos de aprendizaje automático distribuidos en el Edge Computing (computación en el borde), un atacante podría inyectar datos manipulados (data poisoning) para desestabilizar algoritmos de enrutamiento, provocando cuellos de botella artificiales o desviando tráfico sin levantar alertas.

    Vector de AtaqueMecanismo en 6GImpacto Potencial
    Envenenamiento de IA (Data Poisoning)Inyección de telemetría falsa en los modelos de aprendizaje del Edge.Desestabilización de rutas de datos y degradación del servicio.
    Ataques DDoS Distribuidos MasivosBotnets compuestas por millones de sensores del Internet de los Sentidos (IoE).Saturación de capas de orquestación en la nube.
    Compromiso de Redes No Terrestres (NTN)Explotación de enlaces ópticos/láser entre satélites LEO y estaciones terrenas.Intercepción transfronteriza de tráfico global.
    Ataques Criptográficos Post-CuánticosDescifrado de tráfico interceptado mediante futura computación cuántica.Exposición retrospectiva de secretos corporativos y estatales.

    El riesgo de denegación de servicio distribuido (DDoS) adopta dimensiones gigantescas. La proliferación del llamado «Internet de los Sentidos» y la integración de miles de millones de micro-sensores biométricos o industriales sin capacidad de cómputo robusta permitirá a los ciberdelincuentes coordinar botnets con volúmenes de tráfico capaces de abrumar los nodos de procesamiento primario.

    Infraestructura crítica bajo amenaza: repercusiones para la industria y los ciudadanos

    La integración del 6G en servicios esenciales transforma la ciberseguridad de un asunto de privacidad informática en una cuestión de seguridad nacional y de física operativa. En las ciudades inteligentes automatizadas, la señalización del tráfico vehicular, la distribución de agua potable y los sistemas de respuesta médica de emergencia dependerán del mismo tejido de comunicaciones.

    Una interrupción sistemática o la manipulación maliciosa de las rebanadas de red (slices) reservadas para emergencias podría paralizar centros urbanos enteros. La interrupción de la conectividad en un entorno 6G no significará simplemente la imposibilidad de cargar una página web, sino la detención física de líneas de producción robóticas y flujos logísticos autónomos.

    Para los usuarios individuales, el despliegue del radar ambiental JCAS suscita graves dudas éticas y de ciberseguridad. Si la señal de radiofrecuencia de alta frecuencia puede detectar la presencia y movimiento de objetos dentro de un espacio cerrado para optimizar la señal, una brecha en la privacidad de la red permitiría a actores maliciosos reconstruir la disposición interna de una vivienda o rastrear personas sin necesidad de cámaras físicas o GPS.

    Del cifrado tradicional al cómputo cuántico: la estrategia de mitigación

    Para contrarrestar la sofisticación de estas amenazas, los organismos de estandarización como el 3GPP y la ITU postulan que la ciberseguridad del 6G debe asentarse sobre una arquitectura de Confianza Cero (Zero Trust Architecture) continua, combinada con criptografía de vanguardia.

    • Criptografía Post-Cuántica (PQC): Integración de algoritmos matemáticos inmunes a la capacidad de cálculo de los ordenadores cuánticos para asegurar el intercambio de claves y las firmas digitales en los nodos de acceso.
    • Aislamiento de Entornos mediante Micro-segmentación: Creación de barreras criptográficas infranqueables entre slices de red, impidiendo que el compromiso de un sensor doméstico permita la escalada de privilegios hacia redes industriales.
    • Atestación Continuada mediante IA Defensiva: Despliegue de agentes de seguridad autónomos en el borde de la red (Edge) capaces de analizar anomalías en el comportamiento del tráfico y aislar nodos infectados en microsegundos sin intervención humana.
    • Seguridad en la Capa Física (PLS): Utilización de las propiedades inherentes del canal de radiofrecuencia en banda THz (como la direccionalidad extrema de los haces) para evitar la intercepción de señales a nivel de aire (eavesdropping).

    La soberanía tecnológica en el nuevo mapa geopolítico

    El desarrollo del 6G trasciende la competencia comercial de las multinacionales tecnológicas para convertirse en un terreno de disputa geopolítica entre bloques continentales. La definición de los estándares de seguridad que regirán la próxima década dictará qué naciones mantienen la soberanía sobre sus datos e infraestructuras estratégicas.

    A medida que los laboratorios de investigación prueban los primeros prototipos de transmisiones en terahercios, queda claro que la resiliencia del ecosistema digital del futuro no se medirá únicamente por los gigabits transferidos por segundo, sino por la solidez del blindaje que proteja cada bit procesado. La capacidad de anticipar los riesgos invisibles del 6G antes de su despliegue comercial determinará si la próxima revolución de las telecomunicaciones se convierte en el motor de la economía inteligente o en su mayor punto de vulnerabilidad.

  • El punto ciego de la infraestructura global: así funciona la gestión de la postura de seguridad en DNS

    El punto ciego de la infraestructura global: así funciona la gestión de la postura de seguridad en DNS

    Si la red global tuviera un sistema nervioso central, ese sería sin duda el Sistema de Nombres de Dominio (DNS). Este protocolo, diseñado en los albores de las redes informáticas para traducir direcciones IP numéricas complejas en nombres legibles por humanos, procesa miles de millones de peticiones cada segundo. Sin embargo, su omnipresencia y antigüedad lo han convertido en uno de los activos más vulnerables y menos supervisados del ecosistema corporativo.

    Durante décadas, la ciberseguridad corporativa concentró sus inversiones en proteger el perímetro, los endpoints y las aplicaciones web. Mientras las empresas blindaban sus firewalls y migraban arquitecturas hacia la nube, la gestión de los registros DNS permaneció fragmentada entre equipos de infraestructura, departamentos de marketing y proveedores externos de registradores de dominios. Esta falta de gobernanza centralizada abrió una brecha operativa silenciosa pero devastadora.

    Para responder a este desafío ha surgido el DNS Security Posture Management (DNS-SPM), o Gestión de la Postura de Seguridad en DNS. Esta disciplina propone una monitorización continua, auditable y automatizada de toda la superficie de nombres de dominio de una organización, transformando un servicio tradicionalmente estático en un componente activo del centro de operaciones de seguridad (SOC).

    La anatomía del riesgo: del secuestro de registros al fenómeno del Shadow DNS

    El protocolo DNS carecía de mecanismos intrínsecos de autenticación cuando fue diseñado. Aunque extensiones de seguridad como DNSSEC han mitigado parte de la suplantación de identidad mediante firmas digitales, la superficie de ataque moderna se ha trasladado hacia la capa de gestión administrativa.

    +-----------------------------------------------------------------------------------+
    |                        SUPERFICIE DE ATAQUE EN DNS                                |
    |                                                                                   |
    |   +-----------------------+     +-----------------------+     +---------------+   |
    |   |  Subdomain Takeover   |     |     Shadow DNS        |     |  DNS Hijack   |   |
    |   |                       |     |                       |     |               |   |
    |   | Registro CNAME apunta |     | Dominios creados fuera|     | Alteración de |   |
    |   | a recurso eliminado   |     | del control del SOC   |     | credenciales  |   |
    |   +-----------+-----------+     +-----------+-----------+     +-------+-------+   |
    |               |                             |                         |           |
    |               +----------------------+------+-------------------------+           |
    |                                      v                                            |
    |                        [ RIESGO PARA LA ORGANIZACIÓN ]                            |
    |             (Phishing, Intercepción de Tráfico, Robo de Datos)                    |
    +-----------------------------------------------------------------------------------+
    

    Uno de los vectores más agresivos es el secuestro de DNS (DNS hijacking). Los atacantes obtienen acceso comprometiendo las credenciales de los paneles de control en los registradores de dominios o explotando vulnerabilidades en las APIs de administración. Una vez dentro, redirigen las consultas de los usuarios hacia servidores maliciosos capaces de interceptar credenciales bancarias o clonar portales corporativos.

    A este problema se suma el Shadow DNS (DNS en la sombra). Este fenómeno ocurre cuando departamentos internos despliegan subsistemas, campañas de marketing o servicios en la nube sin la supervisión del equipo de ciberseguridad. Estos subdominios suelen crearse con configuraciones temporales que quedan olvidadas tras finalizar los proyectos, convirtiéndose en blancos de fácil acceso.

    El secuestro de subdominios (subdomain takeover) se nutre directamente de esta negligencia. Cuando un registro CNAME apunta a una instancia de la nube que ha sido dada de baja pero el registro DNS no se elimina, un ciberdelincuente puede registrar esa misma instancia vacía en el proveedor de nube y tomar el control total del subdominio legítimo de la empresa.

    Arquitectura de DNS-SPM: visibilidad, correlación y automatización

    La gestión de la postura de seguridad en DNS no es simplemente un analizador de vulnerabilidades; representa una capa de inteligencia continua que se integra con las plataformas de protección de activos en la nube (Cloud Security Posture Management o CSPM) y con las soluciones de gestión de la superficie de ataque (External Attack Surface Management o EASM).

    Función ClaveMétodo Tradicional (Manual)Enfoque DNS-SPM (Automatizado)
    Inventario de ActivosHojas de cálculo desactualizadas y revisiones trimestrales.Descubrimiento continuo de registros zonales en tiempo real.
    Validación de ConfiguraciónVerificación puntual de registros SPF, DKIM y DMARC.Auditoría automatizada contra políticas de cumplimiento y mejores prácticas.
    Detección de Subdominios HuérfanosRevisiones manuales tras incidentes de seguridad.Alertas instantáneas al detectar registros CNAME apuntando a recursos inexistentes.
    Remediación de CambiosFlujos de trabajo lentos vía tickets a soporte técnico.Integración API para revertir o modificar registros maliciosos automáticamente.

    El funcionamiento de una solución DNS-SPM se estructura en tres pilares operativos interconectados:

    1. Descubrimiento y Mapas de Calor: La herramienta analiza continuamente los registros públicos de la zona DNS, los certificados SSL/TLS emitidos para la organización y los logs de resolución para generar un inventario dinámico de todos los dominios y subdominios vinculados.
    2. Evaluación de la Postura de Seguridad: Se audita la configuración de registros críticos como SPF, DKIM y DMARC para prevenir la suplantación de correo electrónico, además de verificar la existencia de firmas DNSSEC válidas.
    3. Orquestación y Respuesta: Ante una modificación no autorizada o la detección de un registro vulnerado, el sistema puede disparar playbooks de remediación automática que aíslan el subdominio o notifican de inmediato al equipo de respuesta a incidentes.
    [Fuentes de Datos: Registradores, Logs de BIND/Unbound, Certificados TLS]
                                     |
                                     v
                     [Plataforma de Análisis DNS-SPM]
                                     |
            +------------------------+------------------------+
            |                                                 |
            v                                                 v
    [Identificación de Vulnerabilidades]           [Evaluación de Cumplimiento]
    (Subdominios huérfanos, CNAMEs caídos)       (Verificación SPF / DMARC / DNSSEC)
            |                                                 |
            +------------------------+------------------------+
                                     |
                                     v
                 [Orquestación API / Remediación en el SOC]
    

    Impacto directo en los sectores bancario, sanitario y de comercio electrónico

    Un fallo en la infraestructura DNS raramente se limita a una interrupción momentánea del servicio; sus secuelas financieras y reputacionales suelen ser profundas. En el sector financiero, un ataque de envenenamiento de caché o secuestro de rutas puede desviar el tráfico de la banca en línea hacia portales de phishing idénticos a los originales sin que la aplicación muestre advertencias de certificado invalidadas si los atacantes lograron emitir certificados fraudulentos.

    En el sector de la salud, donde los sistemas de telemedicina y el intercambio de historiales clínicos dependen de conexiones seguras punto a punto, un error en la resolución DNS puede paralizar la atención médica de urgencia o exponer información altamente confidencial protegida por regulaciones internacionales.

    Por otro lado, para las plataformas de comercio electrónico, el impacto es inmediato. Una mala configuración que provoque la caída del DNS autoritativo durante períodos de alta demanda implica pérdidas millonarias por minuto, afectando no solo la pasarela de pagos sino la reputación de la marca ante los motores de búsqueda y la confianza de los consumidores.

    Medidas preventivas y buenas prácticas para reforzar la postura en DNS

    Para establecer una defensa sólida en la infraestructura de resolución de nombres, los directores de seguridad de la información (CISO) deben trascender la simple auditoría pasiva e implementar controles técnicos transversales.

    • Implementar el principio de mínimo privilegio en los registradores: Limitar el acceso a los paneles de administración de dominios mediante autenticación de múltiples factores (MFA) basada en hardware e integrar controles de acceso basados en roles (RBAC).
    • Activar Bloqueos de Registrador (Registry Locks): Establecer salvaguardas a nivel del propio registrador superior (TLD) que impidan la modificación, transferencia o eliminación de dominios sin una verificación telefónica o fuera de banda previa.
    • Depuración sistemática de registros CNAME: Configurar herramientas automatizadas que identifiquen y eliminen inmediatamente cualquier registro que apunte a almacenamiento en la nube, servidores o balanceadores de carga que hayan sido desmantelados.
    • Adoptar arquitecturas Redundant DNS (Multi-DNS): Distribuir la resolución de nombres entre múltiples proveedores independientes para garantizar alta disponibilidad y mitigar los efectos de ataques masivos de denegación de servicio distribuida (DDoS) dirigidos a la capa de infraestructura.

    La convergencia entre la inteligencia de amenazas y la gobernanza de red

    A medida que las redes corporativas continúan expandiéndose mediante entornos multinube y arquitecturas de microservicios, la complejidad de mantener una visibilidad total sobre los activos digitales seguirá en aumento. El protocolo DNS, ideado en una época de confianza implícita, requiere hoy marcos de gobernanza tan estrictos como los que se aplican al control de identidades o al almacenamiento de datos sensible.

    La consolidación de DNS-SPM como un estándar dentro de las operaciones de ciberseguridad marca el fin de la era en que la infraestructura de nombres se consideraba una configuración de «ajustar y olvidar». En los próximos años, la capacidad de una organización para auditar, asegurar y automatizar la protección de sus registros en tiempo real determinará la resiliencia de toda su presencia digital ante un panorama de amenazas en constante evolución.

  • La trinchera invisible de la IA: cómo el cómputo confidencial protege los modelos mientras piensan

    La trinchera invisible de la IA: cómo el cómputo confidencial protege los modelos mientras piensan

    El despliegue masivo de la inteligencia artificial generativa ha expuesto una grieta crítica en la arquitectura del procesamiento de datos. Mientras los controles de cifrado tradicionales aseguran la información en reposo dentro de los discos duros y en tránsito a través de las redes, los datos quedan completamente desprotegidos al momento de ser procesados por una unidad de procesamiento gráfico (GPU) o de cómputo (CPU). Durante la fase de inferencia, cuando un modelo analiza un patrón o genera una respuesta, la memoria volátil debe leer la información en texto plano, dejándola vulnerable a filtraciones, ataques de extracción de memoria o accesos no autorizados por parte de los propios proveedores de la nube.

    Esta debilidad operativa ha paralizado la adopción de modelos avanzados en sectores con marcos regulatorios estrictos. Instituciones financieras, proveedores de salud y organismos gubernamentales gestionan volúmenes masivos de datos que no pueden correr el riesgo de ser expuestos en la memoria de un servidor de terceros, ni siquiera por microsegundos. La paradoja actual radica en que las herramientas más potentes de análisis predictivo requieren, por diseño, la exposición de los activos más valiosos de una organización.

    Para resolver este dilema ha surgido la IA confidencial (Confidential AI), un paradigma técnico que combina entornos de ejecución seguros (Trusted Execution Environments o TEE) a nivel de hardware con protocolos de cifrado avanzado. Esta tecnología garantiza que ni los administradores del sistema, ni los proveedores de infraestructura multinube, ni eventuales actores maliciosos con privilegios de sistema operativo puedan visualizar los datos mientras el modelo de inteligencia artificial ejecuta sus algoritmos de inferencia.

    El punto ciego de la seguridad digital: la paradoja de los datos en uso

    El modelo clásico de ciberseguridad se ha estructurado históricamente en tres estados del dato: en reposo (data at rest), en tránsito (data in transit) y en uso (data in use). Los dos primeros cuentan con estándares de cifrado robustos como AES-256 o TLS 1.3, ampliamente probados e implementados a nivel global. Sin embargo, el estado «en uso» ha sido el eslabón débil de la cadena. Para que un algoritmo realice operaciones matemáticas sobre un conjunto de información, los datos deben descifrarse y cargarse en la memoria RAM o en la memoria VRAM de los aceleradores de hardware.

    +-----------------------------------------------------------------------+
    |                         ARQUITECTURA TEE                              |
    |                                                                       |
    |   +---------------------------------------------------------------+   |
    |   |                    MEMORIA RAM DEL SISTEMA                    |   |
    |   |                                                               |   |
    |   |   +-------------------------------------------------------+   |   |
    |   |   |          ENCLAVE SEGURO (Hardware Cifrado)            |   |   |
    |   |   |                                                       |   |   |
    |   |   |   +-------------------+       +-------------------+   |   |   |
    |   |   |   |   Datos Sensibles |  -->  | Modelo de IA /    |   |   |   |
    |   |   |   |   (Cifrados)      |       | Inferencia        |   |   |   |
    |   |   |   +-------------------+       +-------------------+   |   |   |
    |   |   +-------------------------------------------------------+   |   |
    |   |                                                               |   |
    |   +---------------------------------------------------------------+   |
    |                                                                       |
    |   [Aislamiento total frente al Sistema Operativo y Hypervisor]        |
    +-----------------------------------------------------------------------+
    

    Con la llegada de la inteligencia artificial a escala industrial, el riesgo asociado a esta vulnerabilidad se multiplicó. Un modelo de lenguaje o una red neuronal requiere procesar millones de registros por segundo. Si un atacante logra comprometer el hipervisor de la máquina virtual o desplegar un malware con privilegios de kernel, puede realizar un volcado de memoria (RAM dump) y extraer variables médicas, secretos comerciales, vectores de incrustación (embeddings) o códigos fuente procesados por la IA.

    A esto se suma el riesgo de la propiedad intelectual del propio modelo. Desarrollar un modelo de IA especializado implica inversiones millonarias en entrenamiento y ajuste fino (fine-tuning). Cuando una empresa despliega su modelo en una nube pública para ofrecer servicios de inferencia, los pesos y parámetros del modelo también quedan expuestos en la memoria durante la ejecución. La IA confidencial aborda esta doble problemática: protege tanto la consulta enviada por el usuario como la estructura interna del modelo que responde.

    La arquitectura del blindaje: Entornos de Ejecución Seguros (TEE) y GPU confidenciales

    La base técnica de la IA confidencial no radica exclusivamente en el software, sino en el hardware. La piedra angular de esta tecnología son los Entornos de Ejecución Seguros (TEE), conocidos técnicamente como «enclaves seguros». Un TEE es un área aislada dentro del procesador central o de la tarjeta gráfica que garantiza que el código y los datos cargados en su interior se mantengan protegidos contra cualquier inspección externa, incluso si el sistema operativo principal está totalmente comprometido.

    Componente de Hardware / ProtocoloFunción en la IA ConfidencialNivel de Protección
    AMD SEV-SNP / Intel TDXAislamiento de memoria a nivel de CPU y máquinas virtuales.Impide la lectura de la memoria RAM por parte del hipervisor.
    NVIDIA H100/H200 Confidential ComputingCifrado directo en la memoria VRAM de la GPU durante la inferencia.Protege los pesos del modelo y los tensores de entrada/salida.
    Atestación Remota (Remote Attestation)Verificación criptográfica del estado del sistema antes de enviar datos.Garantiza que el hardware y el código no han sido alterados.
    Cifrado Homomórfico (Complementario)Ejecución de cálculos matemáticos directamente sobre datos cifrados.Elimina la necesidad de descifrar datos en memoria (alto costo computacional).

    El flujo operativo dentro de un entorno de IA confidencial sigue un proceso estricto de validación criptográfica denominado Atestación Remota. Antes de que el usuario o la aplicación envíe información confidencial al servidor:

    1. El cliente solicita una prueba de autenticidad al hardware de la nube.
    2. El procesador emite un certificado firmado por el fabricante del chip (como AMD, Intel o NVIDIA) que confirma que el enclave seguro está activo y que el código cargado en su interior no ha sido modificado.
    3. Una vez validada la firma criptográfica, el cliente establece un túnel cifrado directamente con la memoria del enclave.
    4. Los datos se descifran únicamente dentro del circuito integrado del procesador, se procesan mediante la IA y los resultados se vuelven a cifrar antes de salir de la GPU o CPU.

    Casos de uso de alto impacto: de la banca privada a la medicina personalizada

    La implementación de la IA confidencial ha dejado de ser un concepto teórico para convertirse en un requisito de despliegue en industrias con alta sensibilidad de datos. En el sector financiero, por ejemplo, las instituciones bancarias utilizan modelos de aprendizaje automático para detectar patrones de fraude transfronterizo en tiempo real.

    [Usuario / Cliente] 
           | 
           |  1. Solicitud de Atestación
           v
    [Servidor de Nube / Hardware TEE]
           |
           |  2. Emisión de Certificado Firmado por el Chip (Intel/AMD/NVIDIA)
           v
    [Validación Criptográfica Exitosa]
           |
           |  3. Envío de Datos Cifrados directamente a la VRAM/RAM
           v
    [Procesamiento e Inferencia dentro del Enclave]
           |
           |  4. Devolución de Resultados Cifrados al Cliente
           v
    [Usuario / Cliente]
    

    Anteriormente, compartir datos de transacciones entre diferentes bancos para entrenar o ejecutar modelos conjuntos violaba las leyes de protección de datos como el RGPD europeo o las normativas sectoriales. Mediante el uso de IA confidencial y aprendizaje federado, múltiples entidades financieras pueden ejecutar un mismo modelo sobre sus bases de datos combinadas dentro de enclaves seguros, analizando los riesgos sin revelar la identidad ni las transacciones de sus clientes a los competidores o al proveedor del servicio.

    En el sector de la salud, el impacto es igualmente transformador. Los centros de investigación médica y las farmacéuticas emplean modelos de visión por computador para analizar imágenes diagnósticas y secuencias genómicas en la búsqueda de terapias personalizadas. La IA confidencial permite que un hospital envíe tomografías de pacientes a un modelo de detección temprana hospedado en la nube sin infringir normas como HIPAA. La información médica procesada en la GPU confidencial no queda registrada en ningún disco de almacenamiento ni puede ser utilizada por el proveedor de la nube para reentrenar modelos comerciales.

    Desafíos técnicos: sobrecostos operativos y la brecha de rendimiento

    A pesar de sus notables ventajas defensivas, la adopción de la IA confidencial enfrenta barreras técnicas considerables. La principal de ellas es la degradación de rendimiento (performance overhead). El proceso continuo de cifrado y descifrado de memoria en tiempo real, sumado a los intercambios de claves y las verificaciones criptográficas de la atestación remota, introduce una latencia adicional que puede afectar aplicaciones que requieren respuestas instantáneas.

    • Latencia en la inferencia: Aunque la última generación de GPU optimizadas para cómputo confidencial ha reducido la penalización a márgenes de entre el 2% y el 7%, en entornos de alta demanda donde se procesan miles de peticiones simultáneas, este retraso acumulado exige una mayor infraestructura de servidores.
    • Complejidad en el desarrollo: Adaptar modelos de inteligencia artificial existentes para que funcionen dentro de entornos de ejecución seguros requiere reestructurar la canalización de software (software pipeline). Los desarrolladores deben empaquetar sus aplicaciones en contenedores compatibles con arquitecturas TEE y gestionar dependencias criptográficas complejas.
    • Costos de infraestructura: El hardware compatible con tecnologías de cómputo confidencial avanzado requiere inversiones de capital elevadas o tarifas más altas en las plataformas de servicios en la nube en comparación con la infraestructura estándar.

    El horizonte regulatorio y la soberanía de los datos

    Las presiones regulatorias globales están acelerando la transición hacia arquitecturas de IA confidencial. Marcos legales recientes, como la Ley de Inteligencia Artificial de la Unión Europea (EU AI Act), exigen niveles rigurosos de gobernanza de datos, trazabilidad y ciberseguridad para los sistemas de IA categorizados como de alto riesgo. En este contexto, la protección de la privacidad durante todo el ciclo de vida del dato pasa de ser una recomendación técnica a una obligación legal con sanciones económicas severas.

    Las multinacionales de tecnología y los proveedores de nube han integrado la IA confidencial en el centro de sus estrategias comerciales. La posibilidad de ofrecer instancias donde el propio proveedor de la nube no tiene acceso técnico a los datos procesados elimina uno de los principales obstáculos para la adopción de la nube pública en jurisdicciones internacionales que exigen soberanía estricta sobre los datos.

    La evolución de la inteligencia artificial dependerá en gran medida de la confianza explícita que las organizaciones puedan depositar en sus sistemas de procesamiento. La IA confidencial redefine el axioma de la seguridad moderna: la protección de la información ya no se limita a crear murallas alrededor de las bases de datos, sino a construir blindajes microscópicos dentro del silicio donde la mente digital realiza sus cálculos.

  • Exposición de datos en plataformas de IA: la fuga silenciosa de información corporativa sin brechas de seguridad tradicionales

    Exposición de datos en plataformas de IA: la fuga silenciosa de información corporativa sin brechas de seguridad tradicionales

    Durante años, las alarmas en los departamentos de ciberseguridad se activaban ante eventos muy concretos: un servidor vulnerado por un ataque de ransomware, un archivo de contraseñas filtrado en un foro de la dark web o un empleado que caía en un engaño de phishing sofisticado. Las métricas de riesgo se medían en función de la solidez del perímetro defensivo y de la velocidad con la que se detectaba cualquier intrusión no autorizada.

    Sin embargo, los informes recientes sobre fuga de datos revelan un patrón profundamente transformador. Las organizaciones están experimentando la pérdida masiva de información altamente confidencial sin que un solo ciberdelincuente haya tenido que atravesar sus cortafuegos ni vulnerar sus credenciales de acceso.

    Esta fuga silenciosa no ocurre por un fallo en la infraestructura de red, sino por la interacción voluntaria, continua e incontrolada de los propios empleados con decenas de plataformas de inteligencia artificial generativa. Al copiar código fuente, adjuntar reportes financieros no públicos o resumir actas de directorio en asistentes virtuales, los trabajadores están transfiriendo activos estratégicos a entornos de la nube pública cuyos términos de privacidad y retention de datos suelen eludir los controles de gobierno de la empresa.

    Qué es la exposición pasiva de datos en la era GenAI

    La exposición de datos en plataformas de IA generativa se define como la salida no intencionada de datos sensibles corporativos —como información de identificación personal (PII), secretos comerciales, propiedad intelectual o datos de clientes— hacia modelos de lenguaje masivos (LLM) o herramientas de productividad basadas en IA que carecen de las garantías de privacidad exigidas a nivel institucional.

    A diferencia de las brechas de seguridad convencionales, donde un actor malicioso busca exfiltrar datos de forma deliberada, en este escenario el movimiento de datos es realizado por usuarios autorizados que buscan optimizar su trabajo diario. Se trata de un fenómeno impulsado por la adopción de herramientas de Shadow AI (inteligencia artificial en la sombra), es decir, el uso de aplicaciones de IA no autorizadas ni auditadas formalmente por los departamentos de tecnologías de la información.

    El problema trasciende el uso de un único chatbot popular. La proliferación de extensiones de navegador, herramientas de resumen automático de reuniones, correctores de estilo algorítmicos y asistentes de programación ha fragmentado la superficie de exposición. Un solo empleado puede estar enviando fragmentos de información confidencial a cuatro o cinco servicios externos distintos en una sola jornada laboral.

    El mecanismo del riesgo: cómo los datos corporativos terminan en el modelo público

    Para comprender el alcance del problema es necesario examinar la ruta técnica que siguen los datos desde que un usuario introduce un texto o adjunta un documento en un asistente de IA hasta que esa información queda expuesta fuera del control institucional:

    [ Empleado en la Empresa ]
               │
               ▼
     ( Entrada de Información ) ──► Datos Sensibles: Código, Estrategia o Reportes Financieros
               │
               ▼
    [ Asistente / Herramienta GenAI ] ──► (Si carece de políticas "Enterprise")
               │
               ├───────────────────────────┐
               ▼                           ▼
    ( Ingesta en la Nube )      ( Reentrenamiento del Modelo )
       Riesgo: Filtración de       Riesgo: Exposición de datos
       repositorios / accesos      a terceros mediante consultas
       no auditados                de otros usuarios (*Prompts*)
    

    Cuando un usuario interactúa con un modelo GenAI en su versión comercial estándar o gratuita, acepta términos de servicio donde habitualmente se estipula que los datos ingresados (prompts, archivos adjuntos y retroalimentación) pueden ser utilizados por el proveedor para reentrenar y mejorar los modelos futuros.

    Este proceso de reentrenamiento altera el estado matemático del modelo. Si los datos sensibles quedan codificados dentro de los pesos de la red neuronal, existe el riesgo comprobado de que esa información pueda ser reconstruida o revelada a usuarios externos mediante técnicas de extracción de datos o consultas cuidadosamente diseñadas (prompt injection o data extraction attacks).

    A este factor se suma la posibilidad de brechas directas en los propios proveedores de IA. Los repositorios donde estas plataformas almacenan el historial de chat y los documentos cargados por millones de usuarios se convierten en objetivos de alto valor para grupos de ciberdelincuencia, multiplicando el impacto de cualquier falla de configuración en la nube del proveedor.

    El choque entre productividad individual y gobernanza corporativa

    El origen fundamental de esta vulnerabilidad no radica en una mala intención de los empleados, sino en la brecha entre el ritmo de adopción tecnológica y la actualización de las políticas internas. La urgencia por acelerar tareas complejas —como el análisis de contratos legales, el procesamiento de datos médicos o la depuración de software— supera la capacidad de respuesta de los equipos de cumplimiento.

    En los sectores financiero, sanitario y legal, este comportamiento genera un impacto regulatorio directo. La carga de información protegida por normativas como el Reglamento General de Protección de Datos (RGPD) en la Unión Europea o la ley HIPAA en Estados Unidos hacia servicios de IA sin acuerdos de procesamiento de datos (Data Processing Agreements o DPA) constituidos formalmente puede acarrear sanciones económicas millonarias, independientemente de que los datos hayan sido explotados o no por un tercero.

    Desde la perspectiva de los usuarios, existe una falsa sensación de confidencialidad al interactuar con una interfaz limpia y conversacional. La mayoría de las personas asumen que el diálogo con un asistente virtual equivale a una nota privada guardada en su propio equipo, ignorando los complejos flujos de transmisión y almacenamiento de datos en servidores remotos que implica cada consulta.

    Casos documentados e investigaciones que confirman la tendencia

    Los estudios presentados por firmas especializadas en ciberseguridad de datos muestran la magnitud del fenómeno a escala global:

    • Estudios de retención e ingesta de datos: Investigaciones de firmas como Cyberhaven señalan que un porcentaje significativo de empleados ha pegado datos confidenciales, planes estratégicos o código fuente propio en herramientas como ChatGPT u otros asistentes conversacionales, siendo el código de software y la información de clientes los elementos más expuestos.
    • Incidentes en la industria tecnológica y de semiconductores: Empresas globales de tecnología han tenido que restringir o prohibir temporalmente el uso de chatbots de IA generativa pública tras detectar que sus desarrolladores habían subido código fuente propietario y datos de diagnóstico de producción para solucionar errores de programación, exponiendo secretos industriales clave.
    • Ataques de extracción de datos memorizados: Investigadores de universidades y centros de ciberseguridad han demostrado empíricamente que es posible inducir a grandes modelos de lenguaje a «recordar» y reproducir fragmentos exactos de textos de entrenamiento —incluyendo direcciones de correo electrónico, claves de cifrado e información privada— mediante la repetición sistemática de palabras clave o comandos específicos.

    El respaldo normativo: las advertencias de los organismos de control

    La preocupación por la salida incontrolada de información hacia plataformas de inteligencia artificial ha llegado a las cúpulas de los organismos reguladores internacionales.

    La Comisión Federal de Comercio de EE. UU. (FTC) ha emitido advertencias explícitas a las empresas sobre el uso de datos de consumidores en el entrenamiento de modelos de IA, señalando que compartir información privada con terceros sin el consentimiento claro de los usuarios puede constituir una práctica engañosa o desleal.

    Asimismo, el Comité Europeo de Protección de Datos (EDPB) creó un grupo de trabajo específico sobre la privacidad en la IA generativa, emitiendo directrices que recuerdan que la introducción de datos personales en modelos de IA requiere bases legales sólidas, derecho de supresión y garantías claras de que la información no será procesada para fines no autorizados por la legislación europea.

    Estrategias operativas para prevenir la fuga de datos por IA

    Frenar la pérdida pasiva de información no requiere bloquear el acceso a la tecnología, sino establecer un marco de Gobernanza de Datos e IA que combine tecnología, políticas y cultura corporativa:

    1. Despliegue de instancias «Enterprise» con garantías de privacidad: Proporcionar a los empleados versiones corporativas de herramientas de IA donde el proveedor garantice formalmente por contrato que los datos no se almacenan para entrenamiento ni se comparten con terceros.
    2. Implementación de soluciones Data Loss Prevention (DLP) adaptadas a la IA: Integrar herramientas de monitoreo en los puntos finales (endpoints) y navegadores capaces de detectar y bloquear en tiempo real el copiado de información sensible (como números de tarjetas, código propietario o identificadores personales) en formularios web de sitios GenAI no autorizados.
    3. Auditoría y visibilidad del mapa de Shadow AI: Utilizar pasarelas de seguridad web (CASB/NG-SWG) para identificar qué plataformas de IA generativa están consumiendo los empleados en la red corporativa y evaluar el nivel de riesgo de cada una.
    4. Políticas de clasificación de datos claras y aplicables: Establecer protocolos sencillos que indiquen qué categorías de información (por ejemplo, pública, interna o estrictamente confidencial) se pueden procesar mediante asistentes algorítmicos y cuáles están estrictamente prohibidas.

    Reconstruir la noción de confidencialidad en el entorno algorítmico

    El auge de la inteligencia artificial generativa ha demostrado que la pérdida de control sobre los activos de información no siempre requiere de una intrusión violenta ni de un fallo informático estruendoso. La mayor amenaza actual a la confidencialidad corporativa puede estar ocurriendo de forma transparente, consulta a consulta, en las pestañas abiertas de los navegadores de la propia organización.

    Abordar este desafío exige que la ciberseguridad trascienda la defensa del perímetro y se enfoque en la trazabilidad del dato. Las empresas que logren equilibrar la productividad impulsada por la inteligencia artificial con una gobernanza estricta de sus activos digitales no solo protegerán su valor estratégico, sino que construirán un entorno operativo verdaderamente preparado para los desafíos de la automatización avanzada.
  • Seguridad de los agentes de software autónomos: la carrera por autenticar, autorizar y auditar a la inteligencia artificial que actúa sin supervisión

    Seguridad de los agentes de software autónomos: la carrera por autenticar, autorizar y auditar a la inteligencia artificial que actúa sin supervisión

    Durante la primera etapa de adopción de los modelos de lenguaje, el control de acceso se resolvía mediante interfaces tradicionales: un empleado introducía sus credenciales, hacía una consulta al chat y recibía una respuesta en texto. La persona actuaba como el filtro definitivo y el único responsable de ejecutar cualquier acción en el sistema.

    Sin embargo, el despliegue masivo de agentes de software autónomos ha dinamitado ese esquema de contención. Hoy en día, los asistentes basados en inteligencia artificial no se limitan a redactar borradores; programan llamadas a bases de datos, interactúan con sistemas de gestión empresarial, aprueban órdenes de compra y coordinan tareas con otros agentes algorítmicos sin requerir confirmación humana en cada paso.

    Esta autonomía funcional plantea un vacío crítico en la ciberseguridad corporativa. Cuando un agente toma decisiones y ejecuta acciones en nombre de un usuario o de una organización, las preguntas fundamentales sobre identidad, permisos y responsabilidad legal cambian drásticamente. Determinar quién autentica al agente, qué límites operativos tiene y cómo se registra su rastro de auditoría se ha convertido en uno de los retos más urgentes para la industria tecnológica.

    Qué es un agente de software autónomo y por qué desafía el modelo de ciberseguridad tradicional

    Un agente de software autónomo es una entidad basada en inteligencia artificial capaz de percibir su entorno, tomar decisiones lógicas en función de un objetivo encomendado y utilizar herramientas externas (como APIs, bases de datos o servicios en la nube) para completar flujos de trabajo complejos de extremo a extremo.

    A diferencia de un script o un bot convencional que sigue instrucciones estáticas programadas línea por línea, el agente autónomo decide dinámicamente qué pasos tomar según el contexto. Esa naturaleza probabilística e indeterminada es precisamente la que rompe los sistemas de gestión de identidades y accesos (IAM) tradicionales.

    Las plataformas de IAM históricas fueron diseñadas bajo dos premisas: autenticar a seres humanos mediante credenciales o biométricos, o autorizar servicios estáticos mediante claves API fijas. Un agente autónomo no encaja en ninguna de las dos categorías. Mantiene un grado de variabilidad operacional que exige modelos de identidad dinámicos, capaces de restringir las atribuciones del bot en función del nivel de riesgo de cada acción individual.

    El triple desafío: autenticación, autorización y auditoría de la IA

    Garantizar la seguridad en el despliegue de agentes exige resolver tres dilemas técnicos interconectados que condicionan la confianza en estos sistemas:

                      [ Triada de Seguridad para Agentes de IA ]
                                         │
        ┌────────────────────────────────┼────────────────────────────────┐
        ▼                                ▼                                ▼
    1. Autenticación Delegada       2. Autorización Dinámica          3. Trazabilidad y Auditoría
     (¿Quién le otorgó el poder?     (¿Hasta dónde puede llegar?      (¿Cómo se prueba lo que hizo?
      Delegación criptográfica)       Mínimo privilegio en tiempo      Registro inmutable de la
                                      real y evaluación contextual)    cadena de razonamiento)
    

    1. Autenticación delegada: certificar la identidad de la entidad sintética

    Un agente no posee identidad jurídica ni conciencia para poseer una clave. Por ello, la autenticación debe resolver la cadena de delegación: comprobar de forma criptográfica e inalterable que el agente está actuando en representación de un usuario o rol corporativo legítimo, y que esa autorización no ha sido revocada ni suplantada por un tercero.

    2. Autorización granular y en tiempo real

    Conceder a un agente un token de acceso con permisos amplios para que «trabaje de forma eficiente» es una receta para el desastre. La autorización debe aplicarse bajo el principio de mínimo privilegio en tiempo real. El sistema necesita evaluar el contexto de cada llamada a una API: si un agente de atención al cliente intenta consultar un registro, se le permite; si intenta exportar la base de datos completa de usuarios, la autorización debe revocarse automáticamente.

    3. Auditoría e imputabilidad: el registro de la cadena de razonamiento

    Cuando un ser humano comete un error o una infracción en un sistema informático, los registros de auditoría (logs) muestran qué usuario inició sesión y qué comando ejecutó. En un agente de IA, un resultado no deseado puede ser consecuencia de una inyección de instrucciones (prompt injection) indirecta o de un sesgo en el modelo. La auditoría no solo debe registrar la acción final, sino también la cadena de razonamiento (Chain of Thought) y los datos de contexto que llevaron al agente a tomar esa decisión.

    Vectores de riesgo: cuando la autonomía algorítmica se vuelve en contra

    La ausencia de gobernanza sobre las identidades no humanas y los agentes autónomos abre la puerta a incidentes operacionales de gran escala.

    • Confuso delegado (Confused Deputy Problem): Ocurre cuando un atacante engatusa al agente mediante lenguaje natural para que utilice sus elevados privilegios del sistema en beneficio del cibercriminal. El agente, creyendo que está cumpliendo una orden válida, ejecuta la acción dañina utilizando sus credenciales legítimas.
    • Apropiación de tokens y persistencia silenciosa: Si los tokens de autenticación concedidos a los agentes no tienen caducidad corta ni restricciones de alcance, un atacante que comprometa el entorno de ejecución del bot puede exfiltrar esas llaves digitales y operar de forma permanente dentro de la red sin levantar sospechas.
    • Cascada de acciones no supervisadas entre agentes: En arquitecturas multi-agente, un error o la manipulación de un primer bot puede propagarse a otros agentes interconectados. Un agente de análisis de mercado comprometido podría enviar datos falsos a un agente de compras, provocando transacciones financieras automáticas e indeseadas.

    La respuesta de los organismos internacionales: el trabajo del NIST y los estándares emergentes

    La urgencia de normar la interacción de agentes autónomos ha llevado a los principales organismos de estandarización a priorizar este ámbito dentro de sus agendas de ciberseguridad.

    El NIST (National Institute of Standards and Technology) de Estados Unidos, a través del desarrollo de perfiles específicos derivados de su AI Risk Management Framework (AI RMF) y de sus guías sobre gestión de identidades (NIST SP 800-63), trabaja activamente en la definición de estándares para las identidades no humanas (NHI) y la delegación de autoridad en sistemas autónomos. El objetivo es estructurar un marco técnico donde la identidad de un agente sea verificable, rastreable y revocable en microsegundos.

    Paralelamente, iniciativas del sector como el proyecto OWASP Top 10 para Agentes de IA están categorizando los fallos de diseño más comunes en la asignación de permisos, sirviendo de guía para que los desarrolladores adopten arquitecturas seguras antes de integrar estos sistemas en entornos de producción.

    Medidas de prevención y buenas prácticas para la gestión de agentes

    Para desplegar agentes autónomos sin comprometer la postura de seguridad de la organización, los equipos de tecnología y ciberseguridad deben implementar una serie de controles fundamentales:

    1. Asignación de identidades efímeras y contextuales: Evitar el uso de claves API estáticas. Los agentes deben recibir credenciales de corta duración que se generen exclusivamente para completar una tarea específica y expiren inmediatamente después.
    2. Aislamiento en entornos de ejecución (Sandboxing): Cada agente debe operar dentro de un contenedor o entorno aislado que limite su capacidad de comunicación con otros recursos de la red corporativa que no sean estrictamente necesarios para su función.
    3. Barandillas de autorización y límites financieros o transaccionales: Definir topes duros a la capacidad operativa de la IA. Cualquier acción que supere un determinado umbral de riesgo (como el borrado de datos masivo o transferencias monetarias) debe requerir una aprobación humana explícita (Human-in-the-loop).
    4. Registros de auditoría inmutables y protegidos: Almacenar los registros de decisiones y llamadas a herramientas del agente en repositorios protegidos contra escritura, permitiendo realizar análisis forenses detallados en caso de comportamiento anómalo.

    Definir las fronteras de la delegación digital

    El verdadero potencial de la inteligencia artificial no se desplegará a través de asistentes conversacionales pasivos, sino mediante agentes autónomos capaces de asumir cargas de trabajo complejas en el mundo real. Sin embargo, la velocidad de la adopción no puede eclipsar los principios elementales de la ciberseguridad.

    Tratar a los agentes de software como usuarios privilegiados sin control o como código inofensivo es un error táctico de consecuencias impredecibles. La construcción de un ecosistema digital resiliente dependerá de la capacidad de la industria para dotar a estos entes sintéticos de una identidad clara, un perímetro de actuación delimitado y una obligación permanente de rendir cuentas sobre cada una de sus decisiones.